
模型操作
模型操作覆盖新建、打开、保存、导入导出数据字典和逆向数据库五类动作。正向建模从新建空模型开始,存量系统从逆向模型开始,两条路径得到的都是可以继续编辑的模型。模型自身的属性和配置项见模型属性。
新建模型
- 从顶部工具栏的“文件”菜单选择新建,打开新建模型类型对话框。
- 选择概念模型建模、逻辑模型建模或物理模型建模(类型差异见模型),输入模型名称后确定;新模型出现在左侧模型树中,同时自动生成一个 main 主题域并显示在画布上。
除“文件”菜单外,还可以使用开始菜单的快捷入口,或使用创建模型的快捷键。客户端中可用的键位以“开始 → 帮助 → 快捷键”中的说明为准,见快捷键。新建后先确认模型类型,类型决定后续能否维护 Schema、分区、表空间等物理属性。
打开数据视图
双击模型树中的模型名称,或右键点击模型名称选择打开数据视图,在画布中打开该模型的 ER 图。模型树展示模型中的全部对象,画布只显示当前主题域引用的对象,差别的原因见主题域。
保存与另存
- 在模型树中右键点击模型名称选择保存或另存。
- 或从顶部工具栏的“文件”菜单选择保存、另存,也可直接单击工具栏左侧的保存图标。
- 另存时选择保存位置,并选择文件格式。
| 保存格式 | 文件特点 | 适用场景 |
|---|---|---|
| 本地二进制模型文件 | 加密文件,只能用客户端打开 | 需要保护模型内容或作为归档 |
| 本地模型文件 | 可读文件,可用文本方式打开编辑 | 需要查看或按文本方式处理模型内容 |
| 在线模型库 | 保存到模型库的目录下,受目录和模型权限约束 | 多人协作建模,权限与版本规则见模型管理 |
图示“另存”对话框:先选择保存路径,再在文件类型中选择本地二进制模型文件或本地模型文件。
导入导出数据字典
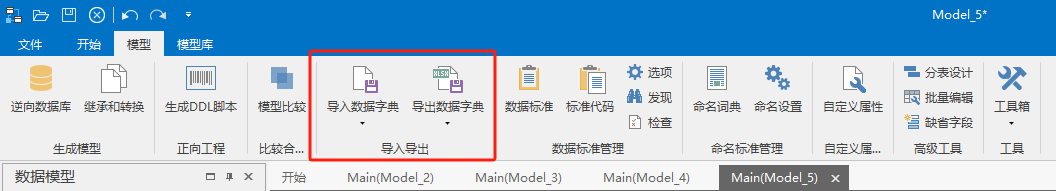
在模型树上右键点击模型名称,或从顶部工具栏的“模型”菜单中选择导入数据字典、导出数据字典,以 Excel 文件格式导出或更新当前模型。
- 打开导入或导出对话框,选择参与的对象范围和对象属性。
- 导出时配置导出规范,确定后生成 Excel 文件。
- 导入时选择已编辑好的文件,确认更新配置和匹配规则后执行。
图示数据字典配置页:核对参与导入导出的对象范围、属性列和更新配置,范围默认值可能大于本次需要处理的对象。
| 配置项 | 说明 |
|---|---|
| 对象范围 | 选择参与导入导出的表、字段等对象 |
| 对象属性 | 选择写入或读取的列,列选得越少,信息丢失越多 |
| 更新配置 | 导入时如何处理与模型中已有对象的差异 |
| 导出规范 | 控制导出文件的命名、编码和列顺序 |
数据字典与模型的信息不等价,导出时会产生信息丢失,包括实体间关系、对象布局、主题域信息、数据库物理属性等。数据字典适合作为元数据清单或批量编辑表字段的途径,不适合作为模型的完整备份。
导出模板中包含 Build-In Id 列。导入时勾选“通过 Id 列匹配和更新表和字段”,系统将使用 Excel 中的 Build-In Id 列与模型内部 Id 严格匹配,该选项适用于“从某模型导出、在 Excel 修改、再导回同一模型”的场景。模型内部 Id 由系统自动产生,不同模型之间互不相同,跨模型使用通常无法匹配,容易误建对象,应先在少量对象上验证。
逆向模型
逆向数据库通过采集库表结构生成模型,不涉及数据库明细数据。逆向得到的模型包含表、字段、索引,以及采集范围内的分区、分片、表空间、序列等物理属性。
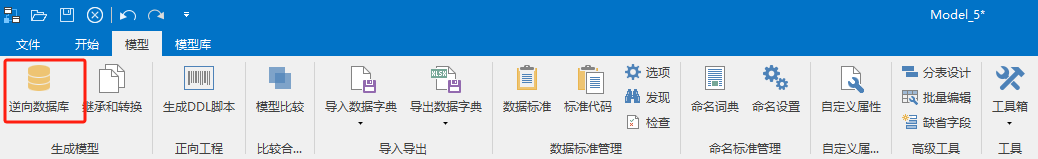
- 从“开始”菜单的“打开”或“模型”菜单选择逆向数据库,在弹窗中选择要逆向的数据库类型。
- 单击下一步,填写连接信息,包括地址、端口、数据库、用户名和密码;不同数据库类型的表单字段不同,也可以从历史连接中选择已有连接。
- 单击测试,连接成功后进入对象选择页;失败时按提示信息核对网络、连接参数、账号权限和驱动。
- 在表/视图选择页确定采集全部表还是部分表。模型较大时推荐使用从服务器获得列表,由服务端执行采集;也可以从 Erwin 文件获得列表。
- 在选项页配置本次逆向的对象类型和中文名来源,并确定逆向结果是本地打开还是直接保存到在线模型库;确定后生成模型,核对表数量、字段类型与关系。
图示逆向选项页:核对参与逆向的对象类型,以及中文名是否取自数据库 comment。
逆向支持的关系型数据库包括 MySQL、Oracle、SQL Server、PostgreSQL、HAWQ、MariaDB、DB2、GaussDB A、openGauss、GBase、SAP HANA、Greenplum、MaxCompute、Hologres、OceanBase(MySQL 与 Oracle 模式)、PolarDB(MySQL 与 Oracle 模式)、Teradata、TiDB、GoldenDB、HashData、达梦、ClickHouse、Vertica、StarRocks 等;支持的非关系型数据库包括 Cassandra、Hive、Impala、MongoDB、Inceptor 等。实际可用的清单以当前版本的逆向数据库类型列表为准。本地逆向数据库需要本机安装 Java 环境,部署要求见运行环境。
注意事项
- 逆向选项中的“是否把数据库 comment 设置为表/字段的中文名”默认勾选。源库 comment 不规范时会把无意义文本带入中文名,建议在逆向前后分别核对。
- 数据字典导入以 Id 匹配为前提,跨模型使用前先在少量对象上验证;从服务器获得列表占用服务端资源,适合大模型。