
创建血缘任务并检查解析报告
血缘任务组织原文件、预处理、解析引擎及对象匹配。先准备元数据和命名空间,再用少量文件验证后扩大范围。
创建任务
- 进入“系统管理 → 血缘管理 → 血缘空间 → 血缘管理”。
- 在目标目录选择“新增任务”。
- 按来源选择
Script或ETL。Excel 自定义血缘属于 ETL;Container of User-Defined-Object是手工血缘编辑保存的不可解析类型。 - 配置任务、引擎与命名空间,导入对应格式文件。
- 检查预处理变量及数据连接,将每个连接映射到正确命名空间。
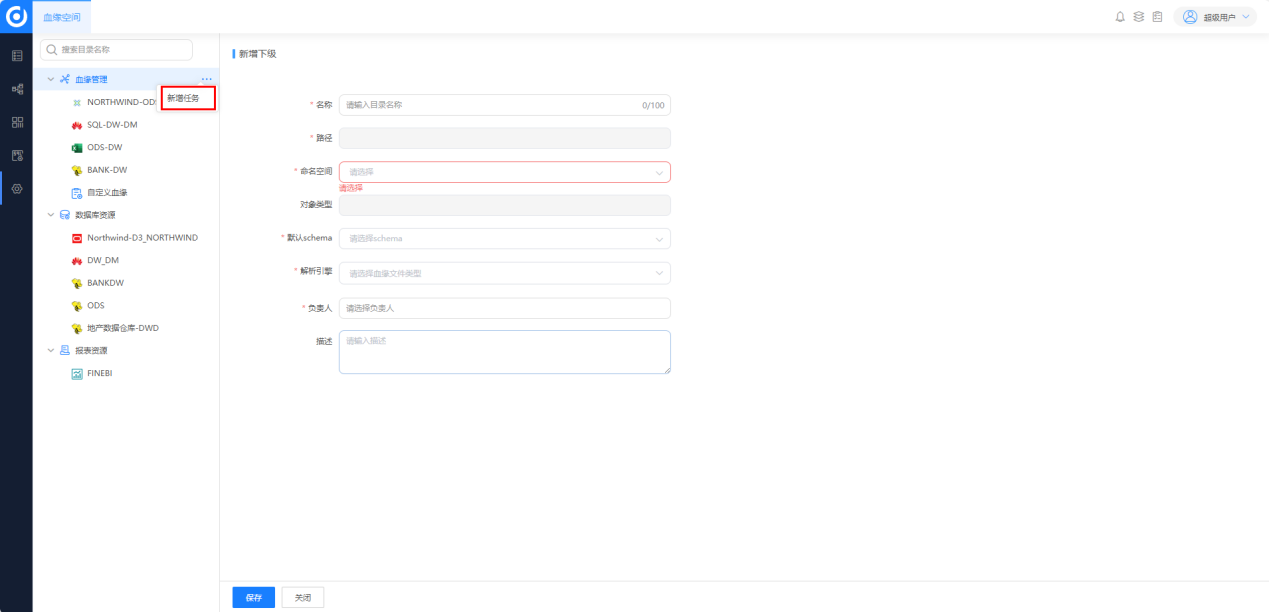
图示展示任务配置位置,任务类型和对象应使用实际业务值。
选择导入方式
| 方式 | 行为 |
|---|---|
| 全量导入 | 导入指定目录脚本,重复文件覆盖并重置为未解析;支持多层目录和不同层同名文件 |
| 增量导入 | 比较内容、大小、路径和文件名,相同跳过,不同更新 |
导入完成后检查文件数量、路径及状态;不要仅根据文件名判断是否重复。
设置元数据限制
默认不强制绑定元数据。开启强制绑定后,任意表或字段无法在命名空间找到对应元数据,都可能导致任务失败。因此先检查元数据采集、Schema、对象命名和连接映射。
存在任何未关联命名空间的数据连接会导致解析失败。跨系统 ETL 尤其应逐个检查源、目标连接。
执行与阅读报告
执行文件解析后,每次生成一个解析任务及起止时间、状态和统计。报告按成功、部分成功、语法错误、元数据缺失、其他错误分类。
- 查看总量与各类结果,打开文件级错误明细。
- 对部分成功文件查看高亮失败代码段。
- 比较原文件和预处理后文件,判断变量及语法是否正确处理。
- 修正引擎、连接、元数据或预处理后重新解析。
- 在实际血缘图抽查关键节点、方向及字段关系。
成功率与元数据覆盖率分别反映解析处理和对象匹配,不应只追求成功文件数而忽略错误来源匹配。