
配置识别算法、规则和任务
智能分类分级按“算法 → 规则 → 任务 → 结果确认 → 评审发布”运行。一般规则使用的正则算法可在算法库维护;血缘级联和机器学习的具体入口、可选规则以环境提供的功能为准。
维护算法库
- 进入“系统设置 → 识别算法 → 算法库”,准备算法目录。
- 在算法列表区域单击“新建”,填写算法名称、目录及正则表达式。目录树中的“新建”用于创建目录,不是算法。
- 输入一条测试数据验证匹配,再用正反例检查误判。
- 确定后按名称或描述查找,按需编辑。
已有引用的算法编辑会提示影响;被规则引用或具有子算法的父算法不能删除。可按模板导入算法;导出时未勾选为全部,勾选为部分。
批量导入从“更多操作 → 导入算法”下载模板后填写,上传文件须保持模板结构。在任务进度浏览中查看导入、导出进度,遇到错误按提示修正记录。列表可按算法名称和描述搜索;算法目录填写名称和描述,目录内仍有算法时不能删除。
如果环境提供“机器学习算法 → 牛刀小试”,可以输入内容查看候选分类及评分。评分范围为 0 至 1 时,数值越高表示相对匹配可能性越大;评分不是业务合规结论或已发布等级。没有该入口时,可先使用一般规则及其条件测试。
用虚构代码验证正则表达式
首次使用可先做下面的小样例。它只验证表达式是否匹配输入文本,不查询真实业务数据,也不把算法保存或发布为治理规则。
- 在新建算法表单填写一个能识别测试用途的名称,选择有权限的算法目录。当前页面在测试前也会校验这些必填项,不能只填表达式。
- 识别算法类型选择“正则表达式”,在“识别算法内容”填写
^[A-Z]{2}[0-9]{4}$,表示完整文本由两位大写字母和四位数字组成。 - 在“测试”输入框填写
AB1234,单击“测试”,检查“符合规则”的结果。 - 将测试文本改成
AB12,再次测试,检查“没有识别到符合规则的内容”。 - 体验完成后单击底部“取消”返回列表。正式使用时,应替换为经业务确认的表达式和正反样本,完成检查后再保存。
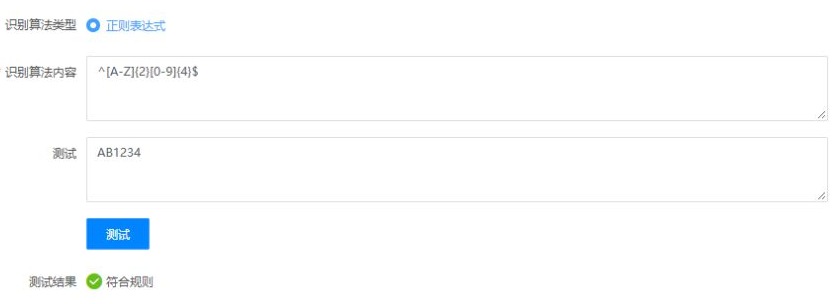
| 测试输入 | 本样例的实际结果 | 说明 |
|---|---|---|
AB1234 | 符合规则 | 两位大写字母加四位数字 |
AB12 | 没有识别到符合规则的内容 | 数字不足四位 |
样例仅演示匹配方向,不代表企业编码规则。算法测试通过后,还需要在一般规则中选取对象进行条件测试,并检查任务结果;不能直接据此批量确认安全分类。
配置识别规则
进入“分类分级工具 → 智能分类分级 → 识别规则”,创建目录后选择页面实际提供的规则类型。当前核对的新建菜单提供“一般规则”;其他环境提供血缘级联或机器学习规则时,再使用对应配置。不要将不同规则类型套用到一般规则表单。
| 类型 | 操作重点 |
|---|---|
| 一般规则 | 选择依赖信息项或直接按安全分类识别;多个条件按与/或组合,选择少量对象进行条件测试 |
| 血缘级联规则 | 按已有血缘向下游推荐;不要套用资产盘点中上游与下游都可选的规则 |
| 机器学习规则 | 选择学习目标:表、依赖已分类表的字段、不依赖表的字段或信息项;填写目标分类/信息项、目录、优先级、评分阈值和推荐条数 |
被任务引用的规则不能删除。调整算法和规则后,重新运行前应检查受影响数据范围。
一般规则的条件测试
- 在“识别规则 → 新建”选择“一般规则”。
- “识别目标”选择“信息项”或“数据分类”。选择信息项时填写识别信息项;选择数据分类时,先选择“表/视图/实体”或“数据项”,再选择目标分类。
- 填写规则名称、目录、描述和优先级,再填写子条件,检查条件组之间的“与”“或”关系。
- 单击“条件测试”,在弹出的元数据选择界面选取少量已知对象。
- 比较预期命中、预期不命中与实际测试结果,确认后保存。
条件测试的样本应同时包含正例和反例。选择范围过大会增加等待时间,先通过小样本检验条件,再配置正式任务。
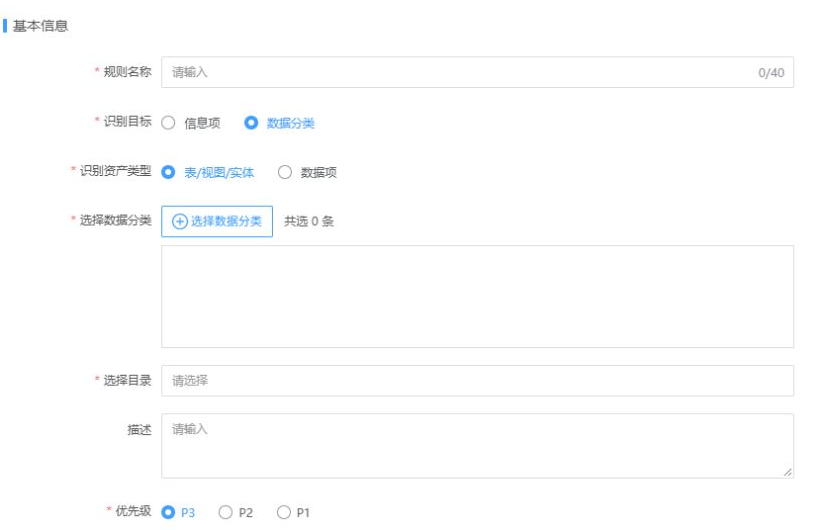
图示展示新建表单的目标配置区域。部分界面的“安全分类”在此显示为“数据分类”。改变识别目标或资产类型后,重新检查已经选择的分类与条件,避免用字段的识别依据处理整张表。
| 字段或控件 | 操作要点 |
|---|---|
| 规则名称 | 按实际识别目的命名,遵守输入长度提示 |
| 识别目标 | 信息项与数据分类两种方式,决定后续需选择的依据 |
| 识别资产类型 | 数据分类方式下选择对象粒度,表/视图/实体与数据项分开 |
| 识别信息项或选择数据分类 | 选择已维护的对应对象,不能只填写分类说明代替选择 |
| 选择目录、描述 | 确定规则归属,记录适用范围与依据 |
| 优先级 | 表单提供 P1、P2、P3;不从标签自行推断多规则冲突后的唯一结果 |
| 新增条件组、条件测试 | 先组合条件,再以少量已知对象检查命中和未命中情况 |
机器学习规则的目标与参数
| 参数 | 如何选择 |
|---|---|
| 对表进行分类 | 选择表要进入的目标安全分类 |
| 对字段进行分类(依赖已分类的表) | 先确认父表已有可用分类,再用对应目标处理字段 |
| 对字段进行分类(不依赖已分类的表) | 选择字段要进入的目标安全分类 |
| 信息项 | 选择字段要依赖的分类信息项 |
| 规则目录、描述、优先级 | 记录归属及用途,核对多个规则同时命中的处理配置 |
| 评分阈值 | 限制候选结果分数,不等同于最终安全等级 |
| 推荐结果 | 指最终识别结果中推荐的分类条数,不是取样数据行数 |
选择不同学习目标后,需选择的分类或信息项不同。保存前确认目标与对象粒度匹配,不能把表级分类直接当成每个字段的最终等级。
创建和运行任务
- 切换“识别任务”,新建任务目录。
- 单击“新建识别任务”,填写基本信息并添加识别规则。
- 确认后检查配置,按需要开启任务。
- 单击“运行”,随后查看结果;“发起成功”仅表示已提交任务。
- 复用时可复制任务并修改名称,重新核对规则及范围。
“开启/关闭”用于切换任务状态,“运行”用于发起本次执行,两者应分别检查。列表按任务名称模糊查询;复制任务的默认名称带“副本”,应改成能区分用途的名称。任务目录有任务时不能删除;删除任务前保留仍需追溯的运行及评审依据。
确认识别结果
在“识别结果确认”按资产名称、系统、数据源、采集名称、表或安全等级筛选;部分界面将该页称为“识别结果”。核对每项来源、分类和级别,必要时通过分类和等级的修改入口调整。
确认正确后提交评审;需要重做时“重新梳理”回到待梳理,仍在范围内的对象会参加后续识别;暂不处理时设为“暂不梳理”。最后由评审人员按评审与发布完成结果确认。
| 处理选择 | 适用情况 | 处理后检查 |
|---|---|---|
| 修改分类或等级 | 对象正确,但推荐结果与依据不符 | 调整的是所选对象,分类与等级分别准确 |
| 提交评审 | 已复核本批对象及建议 | 进入评审流程,不以提交提示替代已发布状态 |
| 重新梳理 | 需要调整依据后再次识别 | 回到待梳理;对象仍在识别范围时会参与下次任务 |
| 暂不梳理 | 本轮暂不处理 | 对象显示为暂不梳理,并记录业务处理原因 |
评审人员通过后分类分级结果才完成发布;驳回的对象回到待梳理。若元数据更新导致某些对象已不存在,批量处理可能同时出现成功和失败项,应按返回明细逐项处理,不只记录整体提示。
没有结果时依次检查任务运行、识别范围、算法测试和规则条件;大量误判时先修正规则和依据,不批量发布以填满覆盖率。